Fiches
Le Web : pages, liens et moteurs de recherche
Comprendre comment une page web est décrite et identifiée, comment les liens hypertextes relient les pages entre elles, et comment un moteur de recherche parcourt, indexe puis classe les pages pour répondre à une requête.
Consulter les définitions clés
Étudier un exemple guidé
Ce que dit la fiche
Les points essentiels
- Une page web est un document décrit avec un langage de balisage, le HTML, qui organise le contenu : titres, paragraphes, images, liens.
- La présentation d'une page (couleurs, mise en page) est décrite séparément en CSS : le HTML porte le fond, le CSS porte la forme.
- Chaque page est identifiée par une URL, adresse unique qui permet au navigateur de la demander au bon serveur.
- Un lien hypertexte pointe vers une autre page : c'est ce maillage de liens qui fait du Web un « réseau de documents ».
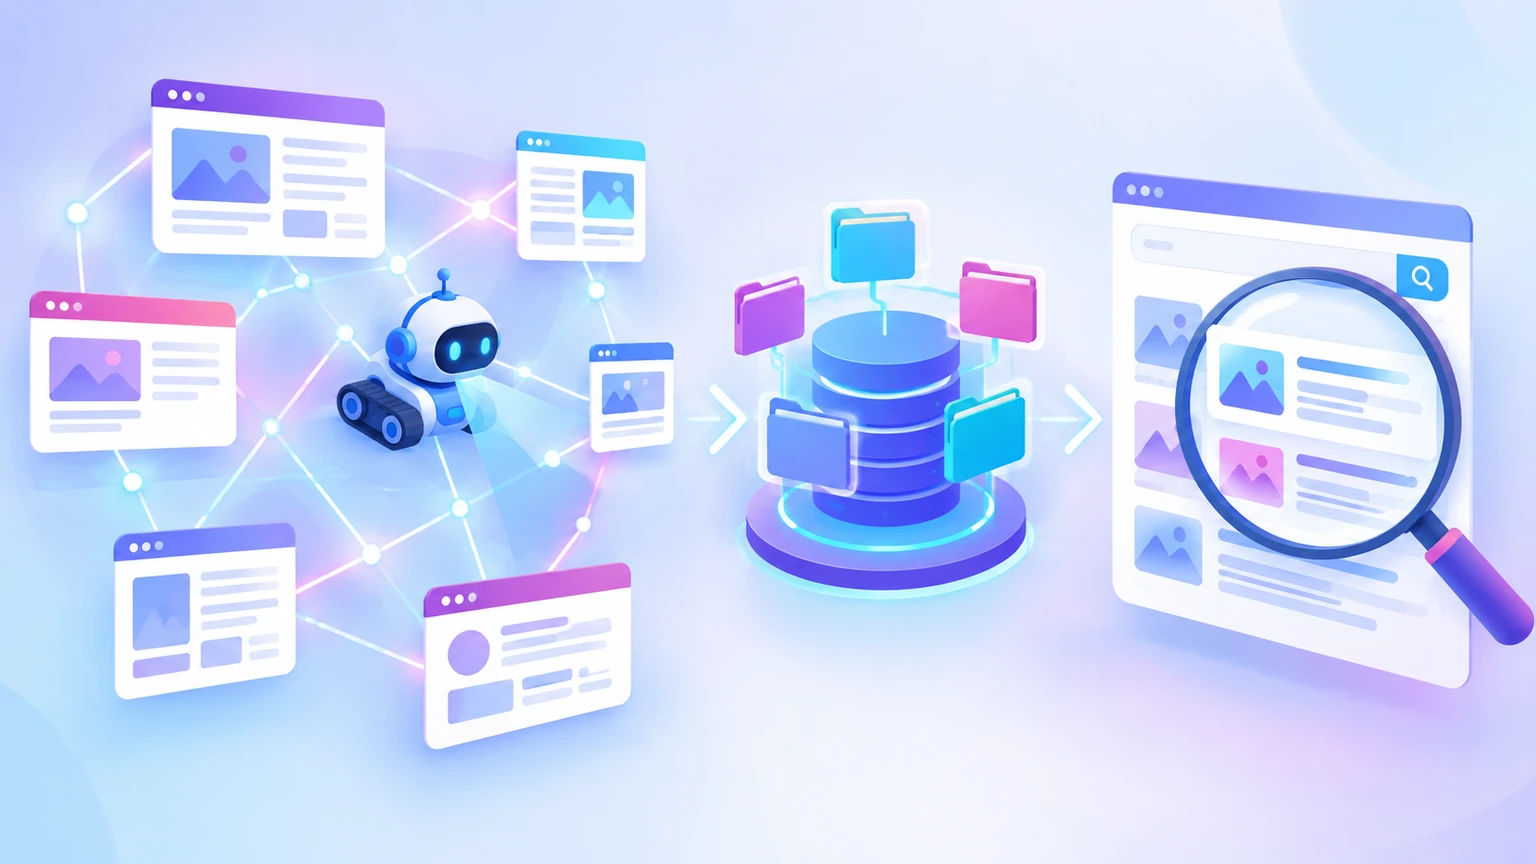
- Un moteur de recherche explore le Web avec des robots, construit un index des pages visitées, puis classe les résultats pour une requête donnée.
- Le référencement regroupe les techniques qui visent à améliorer la position d'un site dans les résultats d'un moteur de recherche.
Les mots à connaître
- Page web
- Document écrit en HTML, publié sur un serveur et accessible par une URL.
- Site web
- Ensemble de pages web liées entre elles, généralement placées sous un même nom de domaine.
- HTML
- Langage de balisage qui décrit la structure et le contenu d'une page web (titres, paragraphes, images, liens).
- CSS
- Langage qui décrit la présentation d'une page web : couleurs, polices, disposition des blocs.
- URL
- Adresse unique d'une ressource sur le Web ; elle indique notamment le protocole, le nom du serveur et le chemin de la ressource.
- Lien hypertexte
- Élément cliquable d'une page qui mène vers une autre ressource, identifiée par son URL.
- Navigateur
- Logiciel installé sur l'appareil de l'utilisateur qui demande une page à un serveur, puis l'affiche.
- Serveur web
- Ordinateur qui stocke des pages et les envoie au navigateur qui les demande.
- Moteur de recherche
- Service qui répond à une requête en proposant une liste ordonnée de pages jugées pertinentes.
- Robot d'indexation
- Programme automatique qui parcourt le Web de lien en lien pour découvrir des pages et les enregistrer.
- Index
- Base de données construite par le moteur : elle associe des mots à des pages, ce qui permet de répondre vite à une requête.
- Référencement
- Ensemble des moyens mis en œuvre pour qu'un site apparaisse mieux placé dans les résultats d'un moteur de recherche.
La méthode, étape par étape
- Étape 1 — Repère le protocole : au début de l'URL, « http:// » ou « https:// ». Le « s » indique que l'échange est chiffré.
- Étape 2 — Repère le nom de domaine : c'est le nom du serveur, par exemple « fr.wikipedia.org ». Il se lit de droite à gauche.
- Étape 3 — Repère le chemin : il indique la ressource demandée sur ce serveur, par exemple « /wiki/Page_web ».
- Étape 4 — Repère les paramètres : tout ce qui suit un « ? » précise la demande, par exemple une recherche ou un numéro d'article.
- Étape 5 — Vérifie la cohérence : le domaine doit correspondre à l'émetteur annoncé avant de faire confiance au contenu.
Des exemples résolus
Décompose l'URL suivante : https://fr.wikipedia.org/wiki/Page_web
Correction
Protocole : https, donc échange chiffré. Nom de domaine : fr.wikipedia.org, le serveur visé. Chemin : /wiki/Page_web, la ressource demandée sur ce serveur. Il n'y a pas de paramètre après un « ? » : l'adresse désigne une page précise. Le navigateur envoie cette demande au serveur fr.wikipedia.org, qui renvoie la page en HTML ; le navigateur l'affiche en appliquant son CSS.
Explique, en trois temps, ce qui se passe entre le moment où tu tapes une requête dans un moteur de recherche et l'affichage des résultats.
Correction
Temps 1 : les robots du moteur ont déjà parcouru le Web de lien en lien et enregistré le contenu des pages dans un index. Temps 2 : quand tu tapes une requête, le moteur interroge cet index pour trouver les pages qui contiennent les mots demandés. Temps 3 : il classe ces pages selon des critères de pertinence et de qualité, puis affiche une liste ordonnée de liens vers ces pages. Le moteur ne visite pas le Web en direct à chaque requête : il répond à partir de son index.
Les pièges à éviter
- Confondre le Web et Internet. Internet est l'infrastructure mondiale de réseaux qui relie les machines ; le Web est un service qui utilise cette infrastructure, au même titre que la messagerie électronique.
- Croire que le moteur de recherche explore le Web au moment où tu tapes ta requête. En réalité, il interroge un index déjà construit par ses robots.
- Croire qu'une URL désigne toujours une page précise. Une même URL peut mener à un contenu différent selon les paramètres qui la suivent.
- Croire qu'un site web est forcément une seule page. Un site regroupe le plus souvent de nombreuses pages reliées par des liens.
Teste-toi
Dans l'URL « https://www.education.gouv.fr/bo/2026.html », quel élément désigne le nom du serveur à contacter ?
Voir la réponse
Le nom du serveur est « www.education.gouv.fr ».
Dans une URL, le protocole vient en premier (« https »), puis le nom de domaine (« www.education.gouv.fr »), puis le chemin de la ressource (« /bo/2026.html »). C'est le nom de domaine qui indique quel serveur le navigateur doit contacter.
Pourquoi un moteur de recherche peut-il répondre très vite à une requête alors que le Web contient des milliards de pages ?
Voir la réponse
Parce que le moteur ne parcourt pas le Web à chaque requête : il interroge un index déjà construit par ses robots.
Des robots parcourent le Web à l'avance, de lien en lien, et enregistrent le contenu des pages dans une base appelée index. Quand une requête arrive, le moteur cherche dans cet index, ce qui est beaucoup plus rapide que de visiter les pages une par une. Il classe ensuite les résultats trouvés avant de les afficher.
Quel est le rôle d'un lien hypertexte dans une page web, et qu'est-ce que cela apporte à l'ensemble du Web ?
Voir la réponse
Un lien hypertexte mène d'une page vers une autre ressource par son URL ; il relie les pages entre elles.
En cliquant sur un lien, l'utilisateur passe d'une page à une autre sans taper d'adresse. Comme chaque page peut contenir plusieurs liens, les pages forment un vaste ensemble de documents reliés. C'est ce maillage qui permet aussi aux robots d'indexation de découvrir de nouvelles pages en suivant les liens.
Ce que tu vas découvrir
- Une page web est un document décrit avec un langage de balisage, le HTML, qui organise le contenu : titres, paragraphes, images, liens.
- La présentation d'une page (couleurs, mise en page) est décrite séparément en CSS : le HTML porte le fond, le CSS porte la forme.
- Chaque page est identifiée par une URL, adresse unique qui permet au navigateur de la demander au bon serveur.
- Un lien hypertexte pointe vers une autre page : c'est ce maillage de liens qui fait du Web un « réseau de documents ».
Dans cette expérience
- Lire les points essentiels
- Consulter les définitions clés
- Étudier un exemple guidé
Pour quel niveau ?
- 2de
- Sciences numériques et technologie
Cette fiche fait partie de notre collection MathématiquesDécouvre toutes nos fiches de 3e pour réviser efficacement !
Voir toutes les fiches de 3e